外泌體組學
挖掘細胞間通訊的微小載體,助力疾病早期篩查與精準作用機制研究。
外泌體 miRNA
外泌體miRNA測序是針對外泌體中微小RNA(microRNA, miRNA,長度18–25nt的非編碼RNA)所開展的專項高通量測序技術。miRNA作為基因表達調控的核心分子,可透過標的mRNA降解或抑制轉譯調控基因功能,而外泌體包裹的miRNA憑藉囊泡膜保護,能抵禦體液中RNA酶的降解,於血清、尿液等體液中穩定性極強,且可透過細胞間通訊將調控資訊傳遞至標的細胞,精準反映源細胞的生理病理狀態。相較於外泌體全轉錄組測序,外泌體miRNA測序聚焦miRNA專項分析,無需兼顧長鏈RNA,可將測序資源集中於小RNA分子,實現更高的測序深度(≥15M reads)與更精準的低豐度miRNA檢出;相較於組織/細胞miRNA測序,外泌體miRNA測序依託無創體液樣品,無需侵入性操作,更適合臨床動態監測、大樣本隊列研究及無法獲取組織樣本的场景。
原理介紹
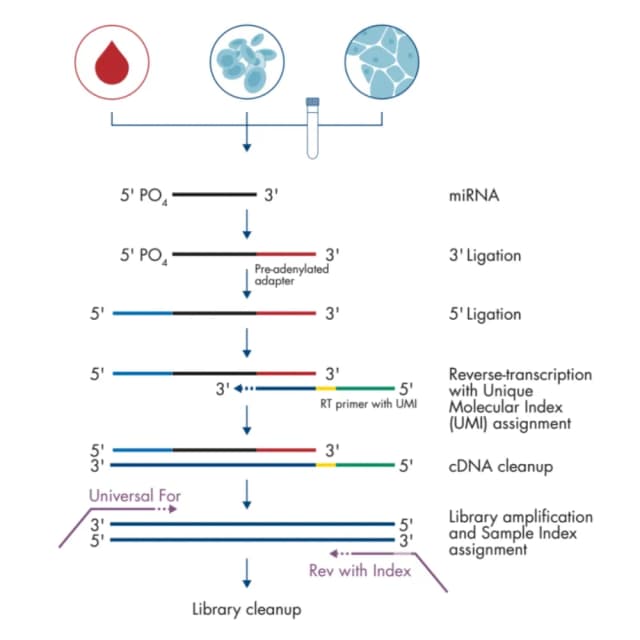
外泌體miRNA測序的核心原理是外泌體純化、小RNA富集、專項測序、功能解析。具體流程:外泌體分離與純度驗證—分離外泌體,去除細胞碎片與游離RNA;透過NTA、Western blot、穿透式電子顯微鏡三重驗證外泌體純度;外泌體小RNA萃取—從純化外泌體中萃取總RNA,重點保留18–25nt的miRNA片段;去除基因體DNA污染,確保RNA純度;miRNA專項文庫建構—在RNA兩端連接特異性測序接頭,透過逆轉錄合成cDNA,再經PCR擴增建構標準化測序文庫;高通量測序—採用Illumina NovaSeq/MiSeq二代測序平台,測序深度≥15M clean reads,保障低豐度miRNA的有效覆蓋;資料處理與功能解析—過濾低品質reads,將有效reads與人類參考基因體及miRNA權威資料庫比對;採用miRanda、TargetScan、PITA等工具預測標的基因,結合GO、KEGG路徑富集分析,挖掘差異miRNA的核心調控功能;建構miRNA-mRNA/lncRNA調控網路,解析其在疾病中的作用路徑。
文獻案例
《Circulation Research》期刊上發表之「Angiogenic Mechanisms of Human CD34+ Stem Cell Exosomes in the Repair of Ischemic Hindlimb」研究論文,揭示CD34Exo可獨立模擬CD34⁺幹細胞的治療效果,改善小鼠缺血後肢的灌流、微血管密度、運動功能,降低截肢率;而去除外泌體的條件培養基則失去該作用。CD34Exo富含促血管生成微小RNA(miRNA),其中miR-126-3p為關鍵成分,敲低該miRNA後,CD34Exo的血管生成活性與治療效果完全消失。CD34Exo可直接將miR-126-3p轉移至缺血組織(不依賴宿主內源性合成),透過抑制標的基因SPRED1,上調VEGF、ANG1、MMP9等促血管生成基因的表達。缺血組織中的內皮細胞對CD34Exo的攝取效率最高,CD34Exo可誘導內皮細胞週期啟動與增殖,進而促進血管新生。CD34Exo透過傳遞促血管生成miRNA介導缺血組織修復,為心血管疾病的無細胞治療提供新方向。採用的miRNA微陣列測序(屬於外泌體miRNA測序技術)是核心研究工具,篩選差異miRNA、關聯外泌體與母細胞功能、鎖定關鍵功能標的,是揭示miRNA介導血管生成機制的前提。
送樣標準
血清≥5mL;血漿≥5mL;尿液≥10mL;腦脊髓液≥2mL;唾液≥3mL;
≥20mL;
≥200μL;
總量≥20ng。
交付內容
資料品質管制報告
外泌體純度鑑定;RNA品質評估;測序品質評估;
miRNA檢測與註釋結果
表達量矩陣,miRNA的TPM/RPM表達量資料,包含已知miRNA與新預測miRNA序列資訊;差異表達分析:差異miRNA篩選結果(火山圖、熱圖),包含miRNA名稱、log2FC、P值、FDR值;資料庫註釋,miRNA的序列資訊、染色體位置、標的基因預測結果;
功能分析結果
GO/KEGG路徑富集分析圖(Top20富集路徑)、miRNA-mRNA調控網路示意圖、差異miRNA共表達聚類分析;
分析與解讀報告
檢測結論,明確核心差異miRNA集合、潛在生物標記物候選名單、與疾病/表型的關聯強度;結果解讀,核心miRNA的調控機制、外泌體來源細胞推測、臨床/研究意義。
常見問題
適合。外泌體miRNA總量通常為pg–ng級,透過以下方案保障可靠性:①選用小RNA專用高靈敏度萃取試劑盒,RNA回收率≥70%;②使用低起始量miRNA文庫建構試劑盒(最低起始量5ng總RNA),最佳化接頭連接效率;③提高測序深度至20M clean reads,增強低豐度miRNA覆蓋;④資料分析時採用嚴格的過濾標準,降低偽陽性。
可以,關鍵在於批次效應控制,核心措施如下:①實驗設計階段—統一樣品類型、外泌體分離方法、測序平台及資料分析流程;②樣品處理階段—多中心樣品集中統一萃取RNA、建構文庫,避免不同實驗室操作差異;③資料分析階段—採用ComBat、SVA等工具對表達量矩陣進行批次校正,透過主成分分析(PCA)驗證校正效果;④統計分析階段—將「批次」作為共變量納入差異分析模型,減少批次對結果的干擾。
