表观组学
解析非序列层面的遗传修饰规律,探索环境如何通过修饰影响基因表达。
MeRIP-Seq
甲基化 RNA 免疫沉淀结合高通量测序技术(Methylated RNA Immunoprecipitation followed by high-throughput sequencing,meRIP-seq ),真核生物的 RNA 分子在转录后会发生多种化学修饰,这些修饰不改变 RNA 的碱基序列,却能精准调控 RNA 的剪接、运输、翻译效率及稳定性,构成了一层重要的基因表达调控网络,被称为 “表观转录组”。在众多 RNA 修饰中,N6 - 甲基腺嘌呤(m⁶A)是真核生物中最丰富、最保守的内部修饰,广泛存在于动物、植物、真菌等物种的 mRNA、lncRNA、circRNA 等非编码 RNA 分子中。随着高通量测序技术与免疫沉淀技术的结合,meRIP-seq 技术应运而生,它的出现打破了传统技术的局限,实现了全转录组范围内特定 RNA 甲基化修饰位点的高通量、高灵敏度检测,成为表观转录组研究的核心技术之一。目前,meRIP-seq 已被广泛应用于生命科学的多个研究领域,在动物研究中,它助力揭示了胚胎发育、干细胞分化、肿瘤发生发展、神经退行性疾病等过程中的 RNA 修饰调控机制;在植物与农业科学研究中,该技术则为解析作物的生长发育、逆境胁迫响应、品质形成、杂种优势等生物学过程提供了全新的视角,为作物分子育种和抗逆改良提供了重要的理论依据和基因资源。\
原理介绍
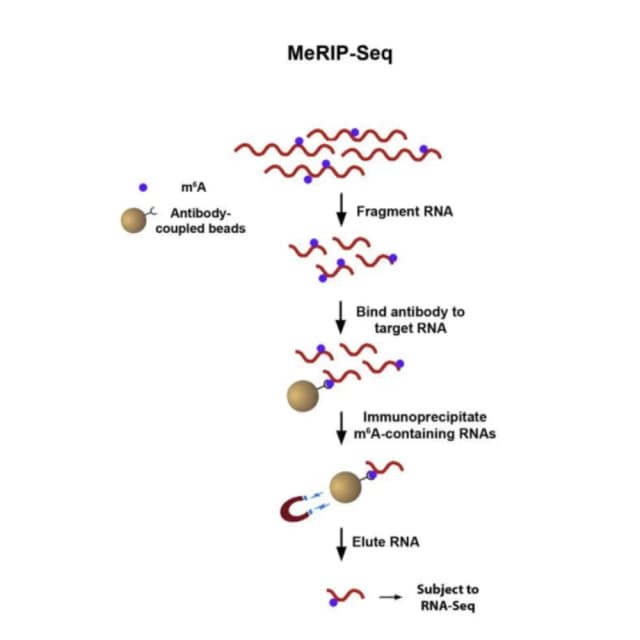
meRIP-seq核心原理是利用特异性抗体对带有目标甲基化修饰的 RNA 片段进行免疫沉淀富集,再结合高通量测序技术,实现全转录组范围内目标修饰位点的鉴定与定量分析。整个实验流程可分为四个关键环节,且每个环节都直接影响最终的实验结果。首先是 RNA 的提取与预处理,其次是免疫沉淀富集过程,这是整个技术的核心步骤。第三是建库与高通量测序,将富集得到的修饰 RNA 片段与 Input 对照 RNA 片段分别进行反转录、末端修复、加 A 尾、连接测序接头等建库步骤,随后利用高通量测序平台进行测序,获得大量的测序读段(reads)。最后是生物信息学分析,首先对原始测序数据进行质量控制,去除低质量读段和接头序列,然后将高质量读段比对到参考基因组或转录组上,通过对比富集组(IP 组)与 Input 对照组的测序深度,识别出甲基化修饰的富集区域(peak),这些富集区域即为潜在的 RNA 甲基化修饰位点。
文献案例
《Genomics Proteomics Bioinformatics》期刊上发表"Reversible RNA Modification N1-methyladenosine (m¹A) in mRNA and tRNA."综述了N1-甲基腺嘌呤(m¹A)在mRNA和tRNA中的分布与功能。m¹A58在tRNA中高度保守,由TRMT6/61A复合物催化,对维持tRNA结构稳定性至关重要,并可被去甲基化酶ALKBH1擦除,从而调控翻译起始。在线粒体mRNA中,m¹A主要位于编码区,由TRMT61B/TRMT10C催化,因其破坏碱基配对能力而抑制线粒体蛋白翻译。文章还指出,不同m¹A-seq研究在位点数量上的差异可能源于实验流程的技术偏差。该工作确立了m¹A作为第二类可逆RNA修饰的地位,揭示其在细胞质与线粒体中动态调控基因表达的重要作用。
送样标准
至少 50 μg (对于人类/动物/复杂样本)。推荐使用 100 μg 以上,以确保后续免疫共沉淀(MeRIP)的顺利进行。部分低丰度样本可能需要更多。
300 ng/μL 或更高。浓度越高越好,以减少样本体积,防止稀释过度。
OD260/280:1.9 - 2.1 ,OD260/230:≥2.0。纯度是关键指标。低 OD260/230 值可能表明有盐、糖、溶剂残留,会干扰后续酶促反应。
RIN 值:≥8.0。关键指标。RIN (RNA Integrity Number) 越高越好。RIN <7.0 的样本通常不建议用于m6A-seq。
推荐使用 RNase-free ddH2O 或 Elution Buffer 溶解。 避免使用 DEPC 水、TE 缓冲液(尤其是含 EDTA 的)或其他可能干扰后续实验的缓冲液。
使用 1.5 mL 或 2.0 mL 螺口冻存管(管壁厚、密封性好)。 标签清晰,标明样本编号、浓度、体积和总质量。
干冰运输。确保运输过程中全程保持 −70∘C 以下,足量干冰持续时间需覆盖运输全程并有富余(如 24 小时运输,准备至少 48 小时的干冰量)。
交付内容
高级分析
差异甲基化基因/ lncRNA / circRNA 分析,差异甲基化 mRNA 的 GO、KEGG、Reactome 功能富集,差异甲基化 lncRNA 的顺式靶基因功能富集,差异甲基化 circRNA 宿主基因的功能通路分析。
个性化分析
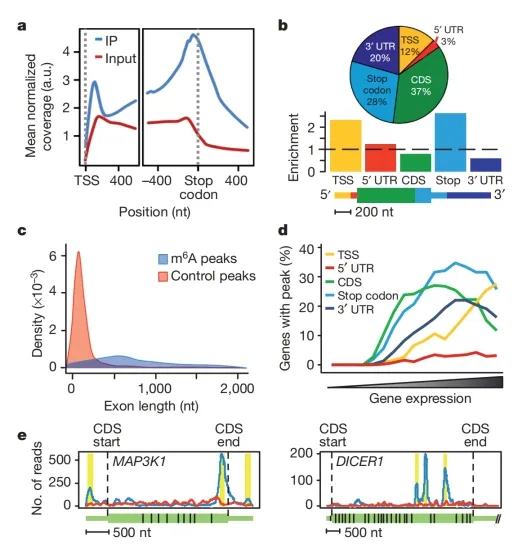
m⁶A 修饰水平与基因表达关联分析,四象限图展示“甲基化-表达”关系。
常见问题
不同修饰的天然丰度与抗体亲和力差异巨大,导致IP效率不一,直接比较其富集水平存在严重偏差。高级解决方案需构建复合内参体系:在实验层面引入已知修饰位点与丰度的合成RNA作为外源spike-in,同时选择一组经其他技术验证的、稳定的内源修饰位点作为内参。在生信分析中,则需建立定量模型,如采用基于spike-in校准的差异丰度分析算法,或开发贝叶斯层次模型,以校正不同修饰IP间的技术变异性,从而实现跨修饰类型的相对定量与比较。
通过统计检验识别显著共现或互斥的修饰组合,并整合RBP结合、RNA结构及修饰酶定位数据,构建条件特异性调控网络,进而利用图论与机器学习推断修饰的添加顺序与相互作用。
