基因組學
從序列到功能,從 DNA 水準探索生命本質,助力基礎科研、育種及臨床轉化的突破。
全基因組測序 (WGS)
人類全基因體重測序(Whole-genome sequencing, WGS)是基於人類基因體參考序列,對個體或族群進行全基因體測序(resequencing),並於個體或族群層級篩選基因體範圍內的遺傳變異,實現基因型多樣性分析、遺傳演化分析、致病與易感性基因、單基因疾病篩檢以及癌症篩檢等。隨著次世代測序(Illumina)技術的發展與普及,全基因體重測序已成為人類遺傳學、轉化醫學與族群演化領域最迅速有效的方法之一,可更全面挖掘全基因體範圍內的序列差異與結構變異,包含單鹼基突變、插入缺失變異、拷貝數變異與結構變異(SNV、SNP、InDel、CNV、SV),於全基因體層級掃描並偵測與表型差異、疾病、演化等相關的突變位點。
原理介紹
文庫建構:DNA 隨機打斷後連接測序接頭,擴增形成文庫。測序:基於邊合成邊測序(Sequencing-by-Synthesis)原理,生成短讀長序列(如 Illumina 的 150 bp)。比對:將測序資料與參考基因體(如 GRCh38)比對,辨識變異位點。變異偵測:透過 GATK、Samtools 等工具偵測 SNP、InDel、SV/CNV。註釋與分析:結合功能資料庫(如 ClinVar、dbSNP)對變異進行註釋,解析其生物學意義。
文獻案例
2025 年 4 月 23 日,美國華盛頓大學作者發表於 Nature 期刊、題為「Human de novo mutation rates from a four-generation pedigree reference」的研究論文,文中利用四代家系(CEPH 1463)的 WGS 資料,首次繪製人類新生突變(DNM)全景圖譜。該研究以四代 28 人家系(CEPH 1463)為對象,透過五種互補測序技術(PacBio HiFi、超長 ONT、Strand-seq、Illumina、Element AVITI)結合長讀長測序(LRS),實現 >95% 基因體的高品質定相與組裝(包含 288 個著絲粒、6 條 Y 染色體),首次建構「端粒到端粒(T2T)」的家系基因體資源。WGS 的核心作用在於:突破技術局限、解析複雜區域—傳統短讀長測序(SRS)無法覆蓋重複序列(如著絲粒、串聯重複),而 WGS 透過長讀長技術(如 PacBio HiFi 的 15–20 kb reads)解決此問題,首次實現這些「基因體暗物質」區域的完整組裝;精確辨識新生突變(DNM):WGS 的高深度(平均 >30×)與高連續性,使研究人員能準確偵測單核苷酸變異(SNV)、插入缺失(Indel)、結構變異(SV)等多種突變類型,尤其是父系生殖系起源的突變(佔 75–81%);建構高解析度遺傳圖譜:結合 WGS 資料,團隊繪製 3.4 kb 斷點解析度的重組圖譜,分析減數分裂交叉與 DNM 的關聯。透過 WGS 的全基因體覆蓋,研究人員明確串聯重複序列(TR)是最易突變的區域(32 個位點反覆突變),且突變率與重複單元大小、基序長度顯著相關。
實驗流程
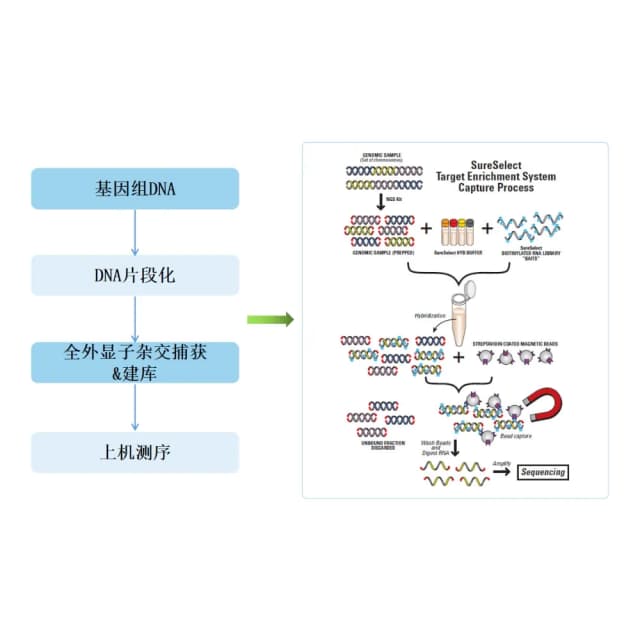
DNA 片段化
樣品基因體 DNA 檢測合格後,以超音波打斷取得隨機 DNA 片段,控制片段大小符合建庫要求,確保片段隨機性與代表性,保障文庫品質
文庫建構前處理
對片段 DNA 進行末端修復與 3′ 端加 A 處理,為後續接頭連接做好準備,減少接頭二聚體,提高連接效率,全面保障文庫建構品質
接頭連接
將測序接頭連接至片段 DNA 兩端,製備初始 DNA 文庫,並確認連接效率,為後續文庫擴增與純化奠定堅實基礎,提升整體建庫成功率
雜交捕獲
使用 Agilent SureSelect 液相試劑盒與文庫雜交,捕獲目標區域序列,提高目標序列佔比,有效降低測序成本與背景干擾
目標片段富集
以磁珠吸附雜交產物並洗脫,回收富集後的目標外顯子序列,有效降低非目標背景干擾,提升測序資料利用率,全面保障目標資料覆蓋深度
PCR 擴增
對富集產物進行 PCR 擴增,獲得滿足測序需求的最終文庫,並控制擴增循環數,避免擴增偏差的累積影響分析結果,確保文庫複雜度達標
文庫品檢
對建構完成的測序文庫進行濃度、純度與片段大小檢測,確認文庫品質合格,並評估片段分佈均一性,滿足上機要求,全面保障測序資料品質穩定
上機測序
品檢合格的文庫於 Illumina 高通量平台進行深度測序,全面獲取樣品高品質原始測序資料,供後續生資分析使用,確保資料完整
測序參數
測序策略採用 PE150 雙端測序,總讀長 300 bp,深度保障資料品質,滿足人類全基因體測序等分析需求,全面支撐變異檢測與遺傳研究
送樣標準
DNA 樣品、血液、組織、細胞株、FFPE 樣品等。
Genomic DNA
DNA 總量≥0.2 μg(建議 0.4 μg)
DNA 總量≥1 μg(建議 2 μg)
DNA 總量≥50 ng
≥5×10⁶ cell
≥50 mg
≥0.6 mL
≥10 片,未染色,100 mm²,5–10 μm 厚度
交付內容
比對結果
BAM/SAM 檔,覆蓋度與比對率統計。
變異偵測
SNP/InDel/VCF 檔,含等位基因頻率、品質值與過濾結果。
功能註釋
ANNOVAR 註釋結果,關聯 GO/KEGG 路徑。
視覺化圖表
染色體覆蓋深度圖、曼哈頓圖、熱圖等。
分析報告
實驗設計、品質參數、變異總結與生物學意義解讀
常見問題
基因體視覺化軟體 IGV 是高效能的基因體資料視覺化工具,能協助使用者同時合併分析不同類型的基因體資料,並靈活放大基因體上的特定區域。
可使用「人類基因體變異相互分析系統」進行後續變異位點篩選;尋找候選變異位點時,可利用變異註釋結果,關注非同義突變、剪接突變、移碼突變。
單基因遺傳病的樣本數一般為患者+非患病父母(3 例)或患者所在三代以上家系(十幾例)左右。
複雜疾病樣本數一般為患病樣本+健康人群(數百至數千例)或三代以上大家系等。
