基因組學
從序列到功能,從 DNA 水準探索生命本質,助力基礎科研、育種及臨床轉化的突破。
簡化基因組測序
簡化基因體測序(Reduced Representation Genome Sequencing, RRGS)是一類透過酵素切刻、片段篩選或標的富集等方式降低基因體複雜度,再對基因體中特定代表性區域進行高通量測序的技術。相較於全基因體重測序,簡化基因體測序不求涵蓋整個基因體,而是以較低成本在全基因體範圍取得大量穩定、可重複的分子標記,特別適合大基因體、重複序列比例高、族群樣本量大或參考基因體不完善的動植物研究。此技術可用於快速開發 SNP、InDel 等遺傳標記,進行遺傳圖譜建構、QTL 定位、BSA 定位、族群遺傳結構分析、遺傳多樣性評估、品種鑑定、親緣關係分析、分子輔助育種與基因體選擇等研究。常見技術類型包含 RAD-seq、ddRAD-seq、GBS、SLAF-seq 等,均屬於「降低基因體複雜度後進行高通量測序」的技術體系。對於需分析大量樣本、但無須取得全基因體所有變異資訊的專案,簡化基因體測序具備成本低、通量高、資料利用率高、分析效率高等優勢。
原理介紹
簡化基因體測序的核心邏輯為「基因體複雜度降低—特定片段測序—標記開發與分型」。首先萃取樣品基因體 DNA,選擇合適的限制制內切酶對基因體進行切刻,使不同樣品在相同酶切位點附近產生可重複的片段;隨後於片段兩端連接帶有樣品 Barcode 的測序接頭,經由片段大小篩選、PCR 擴增與文庫品質控制獲得測序文庫;最後利用 Illumina 等高通量測序平台進行測序。
文獻案例
2022 年,發表於 Ecology and Evolution、題為「ddRAD‑Seq reveals evolutionary insights into population differentiation and the cryptic phylogeography of Hyporhamphus intermedius in Mainland China」的研究論文。該研究利用 ddRAD-Seq 簡化基因體測序技術,對中國大陸間下鱵魚(Hyporhamphus intermedius)8 個地理族群的 156 個個體進行全基因體層級 SNP 分型,成功篩選出 5498 個高品質位點。結果顯示,該物種存在顯著的南—北—高原三相遺傳結構,南方與北方族群已高度分化(FST > 0.3),且雲南高原引入族群的遺傳背景更接近北方長江流域族群;環境關聯分析(GEA)進一步揭示溶氧與溫度是驅動其局域適應的關鍵因子,顯示地理隔離與環境異質性共同塑造了該物種的隱存譜系分化與族群演化歷史。
實驗流程
基因體 DNA 萃取與品檢
從組織或血液樣品中萃取高品質基因體 DNA,採用電泳與分光光度法檢測濃度、純度與完整性,嚴格確保品質符合酶切建庫與測序要求,保障建庫成功率
基因體 DNA 酶切處理
依據物種基因體特性設計酶切方案,利用限制性內切酶酶切基因體,獲得大小均一的目標片段,適用於目標區域高效測序,有效降低測序成本與背景干擾
建庫修飾與片段篩選
為酶切片段連接帶樣品標籤的測序接頭,再以磁珠或凝膠電泳篩選目標大小片段,確保文庫片段集中,提升文庫製備效率與品質,滿足上機要求
文庫擴增純化與品檢
對連接產物進行 PCR 擴增並純化,隨後檢測文庫濃度與片段大小分佈,確認文庫品質滿足上機測序要求,全面保障測序資料品質穩定可靠
高通量上機測序
將不同樣品文庫按等量比例混合後於高通量平台測序,獲取深度覆蓋目標區域的高品質原始測序資料,供後續生物資訊分析使用,保障資料品質
測序資料品控與比對
對原始資料進行過濾與樣品拆分,並將潔淨序列比對至參考基因體,完成聚類與冗餘序列處理,全面保障後續變異檢測準確性,奠定資料基礎
變異偵測與基因型過濾
挖掘樣品間的變異位點並進行精準基因分型,設定嚴格品質閾值過濾低品質變異,確保結果可靠穩定可用,為遺傳分析與後續應用研究提供堅實資料基礎
遺傳分析與基因註釋
開展遺傳多樣性與群體結構等系統性遺傳分析,篩選候選基因並完成功能註釋與富集解讀,為後續應用研究提供資料支撐,輸出完整分析報告
送樣標準
總量≥0.5 μg,建議≥1 μg
≥20 ng/μL
OD260/280=1.8–2.0,OD260/230≥1.8
無明顯降解,主帶清晰
≥25 mg
≥200 mg
≥0.6 mL
≥0.1 mL
建議提前溝通評估
交付內容
標準分析結果
1) 資料品控報告:統計原始資料量、Clean Data 資料量、Q20、Q30、GC 含量、接頭污染與低品質序列過濾情形。 2) 樣本拆分結果:依 Barcode 資訊將混合測序資料拆分至各樣本,並統計各樣本資料量與有效 Reads 比例。 3) 標籤聚類或參考基因體比對結果:有參考基因體時提供比對率、覆蓋情形等統計;無參考基因體時提供標籤聚類結果。 4) 變異偵測與過濾:偵測 SNP/InDel 位點,並依測序深度、缺失率、等位基因頻率等指標進行品質過濾。 5) 基因型分型結果:提供各樣本於高品質標記位點上的基因型矩陣,便於後續遺傳分析。
分析與個人化結果
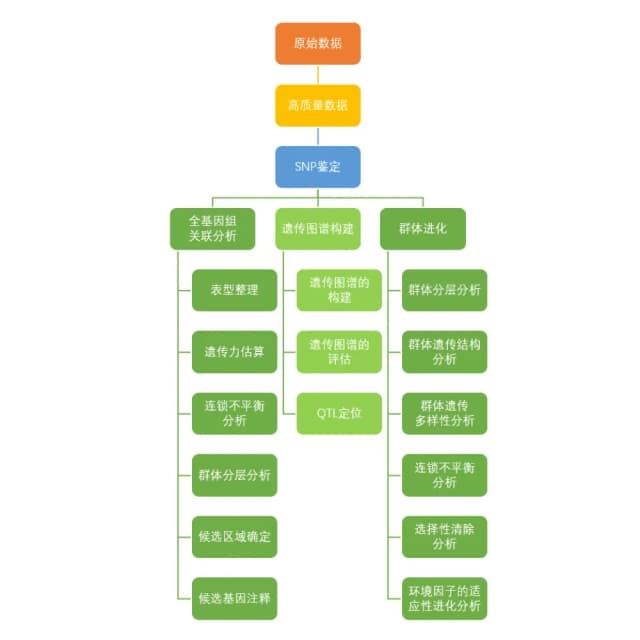
遺傳圖譜建構:提供標記分群、遺傳距離、連鎖圖譜與標記分布結果。 QTL 定位或 BSA 分析:定位與目標性狀相關的候選區間,並結合基因註釋篩選候選基因。 族群遺傳學分析:包含 PCA、系統發育樹、族群結構、遺傳多樣性、Fst 與親緣關係分析等。 GWAS 分析:結合表型資料進行全基因體關聯分析,篩選與目標性狀相關的顯著位點與候選基因。
視覺化結果
變異檔:以 VCF 等標準格式儲存變異位點資訊。 基因型矩陣:提供適用於遺傳分析軟體的格式化檔案。 視覺化圖表:包含 SNP 密度圖、樣本聚類圖、PCA 圖、族群結構圖、系統發育樹、遺傳圖譜、QTL 定位圖、BSA 關聯圖與 GWAS 曼哈頓圖等。
常見問題
可以。沒有參考基因組時,可通過標籤序列聚類構建參考標籤,並基於共有標籤進行 SNP 開發和基因型分型。但如果研究目標涉及候選基因註釋、候選區域精確定位或與基因組位置相關的分析,有高質量參考基因組會顯著提高結果解釋能力。
主要有覆蓋率和覆蓋深度。覆蓋率是指測序得到的鹼基佔全基因組的比例;覆蓋深度是指單個鹼基被測到的平均次數。覆蓋率可以反映出分子標記是否具有代表性,覆蓋深度決定了分子標記檢測的準確度。
有參考基因組的物種獲得的 SNP 準確性更高。
要求分子標籤在全基因組上均勻分佈,在不同個體之間具有特異性等。同時,根據不同的研究目的,對分子標籤的密度要求也有所不同。
