表觀遺傳學
解析非序列層面的遺傳修飾規律,探索環境如何透過修飾影響基因表現。
MeRIP-Seq
甲基化RNA免疫沉澱結合高通量測序技術(Methylated RNA Immunoprecipitation followed by high-throughput sequencing,meRIP-seq)—真核生物的RNA分子於轉錄後會發生多種化學修飾,這些修飾不改變RNA的鹼基序列,卻能精準調控RNA的剪接、運輸、轉譯效率與穩定性,構成一層重要的基因表達調控網路,被稱為「表觀轉錄組」。在眾多RNA修飾中,N6-甲基腺嘌呤(m⁶A)是真核生物中最豐富、最保守的內部修飾,廣泛存在於動物、植物、真菌等物種的mRNA、lncRNA、circRNA等非編碼RNA分子中。隨著高通量測序與免疫沉澱技術的結合,meRIP-seq應運而生,打破傳統技術的局限,實現全轉錄組尺度特定RNA甲基化修飾位點的高通量、高靈敏度檢測,成為表觀轉錄組研究的核心技術之一。目前meRIP-seq已廣泛應用於生命科學多個領域:於動物研究中助力揭示胚胎發育、幹細胞分化、腫瘤發生發展、神經退化性疾病等過程的RNA修飾調控機制;於植物與農業科學研究中,則為解析作物生長發育、逆境脅迫響應、品質形成、雜種優勢等生物學過程提供全新視角,為作物分子育種與抗逆改良提供重要理論依據與基因資源。
原理介紹
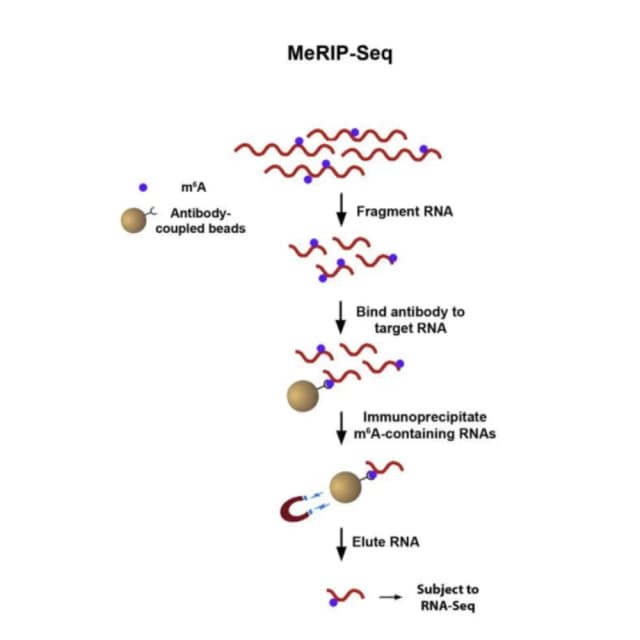
meRIP-seq核心原理是利用專一性抗體對帶有目標甲基化修飾的RNA片段進行免疫沉澱富集,再結合高通量測序,實現全轉錄組尺度目標修飾位點的鑑定與定量分析。整個實驗流程可分為四個關鍵環節,每一環節皆直接影響最終結果。首先是RNA的萃取與前處理,其次是免疫沉澱富集過程,此為整個技術的核心步驟。第三是建庫與高通量測序,將富集得到的修飾RNA片段與Input對照RNA片段分別進行反轉錄、末端修復、加A尾、連接測序接頭等建庫步驟,隨後利用高通量測序平台測序,獲得大量測序讀段(reads)。最後是生物資訊分析,先對原始測序資料進行品質管制,去除低品質讀段與接頭序列,再將高品質讀段比對至參考基因體或轉錄組,透過比較富集組(IP組)與Input對照組的測序深度,辨識出甲基化修飾的富集區域(peak),這些富集區域即為潛在的RNA甲基化修飾位點。
文獻案例
《Genomics Proteomics Bioinformatics》期刊發表之「Reversible RNA Modification N1-methyladenosine (m¹A) in mRNA and tRNA.」綜述了N1-甲基腺嘌呤(m¹A)於mRNA與tRNA中的分布與功能。m¹A58於tRNA中高度保守,由TRMT6/61A複合物催化,對維持tRNA結構穩定性至關重要,並可被去甲基化酶ALKBH1抹除,從而調控轉譯起始。於粒線體mRNA中,m¹A主要位於編碼區,由TRMT61B/TRMT10C催化,因其破壞鹼基配對能力而抑制粒線體蛋白轉譯。文章亦指出,不同m¹A-seq研究在位点數量上的差異可能源於實驗流程的技術偏差。該工作確立了m¹A作為第二類可逆RNA修飾的地位,揭示其在細胞質與粒線體中動態調控基因表達的重要作用。
送樣標準
至少 50 μg(針對人類/動物/複雜樣品)。建議使用 100 μg 以上,以確保後續免疫共沉澱(MeRIP)順利進行。部分低豐度樣品可能需要更多。
300 ng/μL 或更高。濃度越高越好,以減少樣品體積,防止過度稀釋。
OD260/280:1.9 - 2.1,OD260/230:≥2.0。純度為關鍵指標。OD260/230值過低可能表示有鹽、糖、溶劑殘留,會干擾後續酵素反應。
RIN值:≥8.0。關鍵指標。RIN越高越好。RIN <7.0 的樣品通常不建議用於m6A-seq。
建議使用 RNase-free ddH2O 或 Elution Buffer 溶解。避免使用 DEPC 水、TE 緩衝液(尤其含 EDTA 者)或其他可能干擾後續實驗的緩衝液。
使用 1.5 mL 或 2.0 mL 螺口凍存管(管壁厚、密封性好)。標籤清晰,標明樣品編號、濃度、體積與總質量。
乾冰運輸。確保運輸全程維持 −70°C 以下,乾冰量需足以覆蓋運輸全程並有餘裕(如24小時運輸,準備至少48小時的乾冰量)。
交付內容
進階分析
差異甲基化基因/lncRNA/circRNA分析、差異甲基化mRNA的GO、KEGG、Reactome功能富集、差異甲基化lncRNA的順式標的基因功能富集、差異甲基化circRNA宿主基因的功能路徑分析。
客製化分析
m⁶A修飾層次與基因表達關聯分析、四象限圖展示「甲基化-表達」關係。
常見問題
不同修飾的天然豐度與抗體親和力差異巨大,導致IP效率不一,直接比較其富集層次存在嚴重偏差。進階解決方案需建構複合內參體系:於實驗層面引入已知修飾位點與豐度的合成RNA作為外源spike-in,同時選擇一組經其他技術驗證、穩定的內源修飾位點作為內參。於生資分析中則需建立定量模型,如採用基於spike-in校準的差異豐度分析演算法,或開發貝氏層次模型,以校正不同修飾IP間的技術變異,實現跨修飾類型的相對定量與比較。
透過統計檢定辨識顯著共現或互斥的修飾組合,並整合RBP結合、RNA結構及修飾酶定位資料,建構條件特異性調控網路,進而利用圖論與機器學習推論修飾的添加順序與相互作用。
