表觀遺傳學
解析非序列層面的遺傳修飾規律,探索環境如何透過修飾影響基因表現。
WGBS
全基因體甲基化(Whole-Genome Bisulfite Sequencing, WGBS)是目前研究 DNA 甲基化最全面、解析度最高的方法之一,廣泛應用於表觀遺傳學、發育生物學、腫瘤學等領域。DNA 甲基化是真核生物中最常見的表觀遺傳修飾形式,主要發生於 CpG 二核苷酸中胞嘧啶的 5′ 位碳原子上,形成 5-甲基胞嘧啶(5mC)。此修飾在不改變 DNA 序列的前提下調控基因表達,參與細胞分化、X 染色體去活化、銘印基因調控、轉位子靜默等關鍵生物學過程。異常的甲基化模式與多種疾病(如癌症、神經退化性疾病、自體免疫疾病)密切相關。傳統甲基化檢測方法(如甲基化特異性 PCR、MeDIP)存在覆蓋度低或解析度不足問題。WGBS 透過亞硫酸氫鹽(bisulfite)處理結合高通量測序,可實現單鹼基解析度、全基因體範圍的甲基化圖譜繪製。
原理介紹
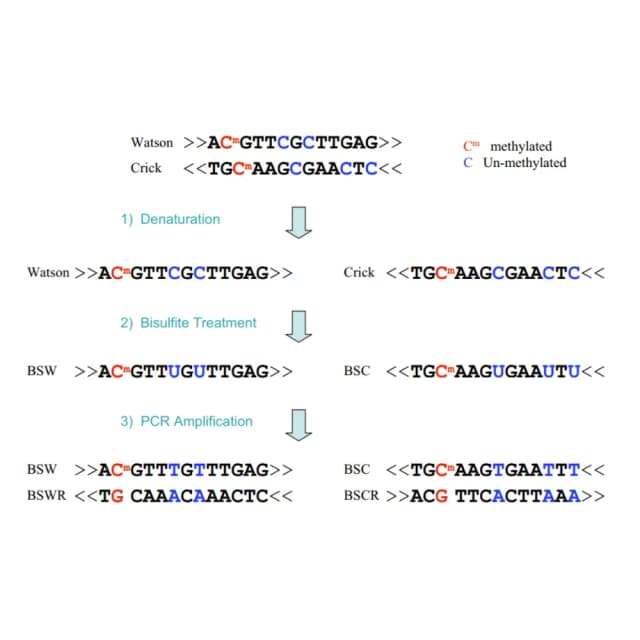
全基因體甲基化的核心原理是亞硫酸氫鹽(sodium bisulfite)可將未甲基化的胞嘧啶(C)脫胺基轉化為尿嘧啶(U),在後續 PCR 擴增中被讀作胸腺嘧啶(T);而甲基化的胞嘧啶(5mC)對亞硫酸氫鹽具有抗性,保持不變。透過比對原始參考基因體與測序結果中 C→T 的轉換情況,即可判斷每個 C 位點是否甲基化。
文獻案例
《Cell Stem Cell》期刊發表「Naïve human pluripotent cells feature a methylation landscape devoid of blastocyst or germline memory.」研究論文,運用全基因體亞硫酸氫鹽測序(WGBS)系統比較在 5iLAF 或 t2iL+Gö 等 naïve 培養條件下獲得的人類胚胎幹細胞(hESCs)與體內人類囊胚、卵母細胞及 primed hESCs 之間的 DNA 甲基化圖譜。研究發現,儘管 naïve hESCs 在轉錄組上高度模擬人類著床前上胚層(如高表達 KLF 家族、NANOG,低表達 OTX2、ZIC 家族),並呈現整體低甲基化狀態(平均 CG 甲基化水平接近囊胚),但其甲基化景觀卻顯著偏離體內真實 naïve 狀態:不僅無法重建母源「瞬時銘印」(transient maternal imprints)的甲基化模式,更在全部 31 個穩定原發性銘印控制區(如 H19、SNRPN)發生近乎完全的甲基化丟失,導致銘印基因由單等位表達轉為雙等位表達;此外,naïve hESCs 的甲基化圖譜與人類 MII 期卵母細胞和囊胚的相關性極弱,表明體外培養過程徹底抹除配子與早期胚胎的「甲基化記憶」。機制上,作者揭示 naïve 狀態下 DNMT1/UHRF1 維持甲基化路徑被抑制,同時 TET1/2 氧化酶表達顯著上調,共同驅動全域性去甲基化與銘印擦除。該研究首次系統揭示目前 naïve 重程式策略雖可實現轉錄層面的「返祖」,卻無法忠實重現體內表觀遺傳藍圖,對 naïve hESC 在疾病建模與再生醫學中的應用提出重要警示。
送樣標準
提供 ≥2 μg 純淨 DNA,去除 RNA 及蛋白殘留;濃度 ≥20 ng/μL,基於 Qubit 定量;建議使用新鮮組織或從新鮮組織萃取的 DNA。
取樣量不少於 10–30 mg(約綠豆至黃豆大小),離體後立即以生理食鹽水清洗,吸乾表面水分,冰上分割成小塊,液氮速凍,−80℃ 保存。避免使用 RNAlater、TRIzol 或酒精等試劑保存。
提供不少於 2×10⁶ 個細胞。貼壁細胞需先消化收集,懸浮細胞可直接處理;用 PBS 洗滌一次,600 g 離心 5 分鐘,棄上清保留沉澱;液氮速凍,−80℃ 保存。
哺乳類動物:≥2 mL 周邊血;紅細胞有核物種:≥0.5 mL。採集於 EDTA 抗凝血管,避免肝素管;液氮速凍,−80℃ 保存。不接受 RNAlater、TRIzol 或酒精保存。
提供不少於 15 張切片,組織面積≥1 cm²,厚度 4–10 μm;腫瘤細胞佔比不低於 30%;置於 1.5 mL 或 2.0 mL 離心管中保存。
若用於 cfDNA 分析,需提供 >15 ng cfDNA,片段分布良好,單核小體 cfDNA 佔比≥50%;或提供 1–4 mL 血漿/血清,專用採血管採集。注意:cfDNA 經亞硫酸鹽處理後片段更短,建庫成功率較低,僅推薦風險建庫。
建議取幼嫩葉片等富含核酸部位,總量不少於 300 mg;多酚或多糖類植物建議增加送樣量或提前萃取 DNA;避免使用化學試劑保存,液氮速凍,−80℃ 儲存。
提供不少於 100 ng DNA,濃度≥2 ng/μL,基於 Qubit 定量。適用於低起始量研究,需特別注意純度控制。
如唾液、尿液、灌洗液、拭子、分泌物等,請提前諮詢技術支援確認是否適用及具體處理方法。
交付內容
標準分析
甲基化位點辨識與基礎統計:單鹼基解析度甲基化水平計算、全基因體及不同序列背景(CpG、CHG、CHH)甲基化水平分布、不同基因體元件(啟動子、外顯子、內含子、重複序列等)甲基化水平比較。
差異甲基化區域(DMR)鑑定
使用 metilene、DSS 或 methylKit 等工具辨識 DMR,DMR 基礎統計(數量、長度、甲基化變化方向)。
功能富集分析
DMR 關聯基因鑑定(基於最近 TSS 或重疊基因體)、GO 生物程序與 KEGG 路徑富集分析、銘印基因與重複元件分析。
進階分析
多組比較與動態甲基化分析、多時間點/多處理組 DMR 聚類、甲基化軌跡視覺化。
整合多組學分析
與 RNA-seq 聯合分析:啟動子甲基化 vs. 基因表達相關性、與 ATAC-seq/ChIP-seq 整合、單等位甲基化分析、基於雜合 SNP 位點分析親本特異性甲基化(ASM)。
客製化視覺化
IGV 瀏覽器截圖(關鍵基因/ICR 區域)、Circos 圖展示全基因體甲基化分布、曼哈頓圖展示 DMR 在染色體上的分布。
常見問題
針對特定缺陷(如銘印丟失),可運用標的表觀遺傳編輯技術精確修復位點甲基化,直接驗證其功能影響。同時,基於 WGBS 揭示的甲基化酶表達變化,透過遺傳學手段操控其活性,可深入探究調控機制。這些發現最終能指導培養體系優化,以獲取表觀遺傳更完善的細胞模型。
甲基化與表達資料的矛盾常揭示複雜調控,可能原因包含:基因體甲基化與轉錄活化相關、等位基因特異性效應的掩蓋,或甲基化透過三維基因體遠距調控其他基因。整合染色質構象資料與運用單細胞多組學技術,是釐清群體平均資料下異質性真相的關鍵。
